Factures et reçus
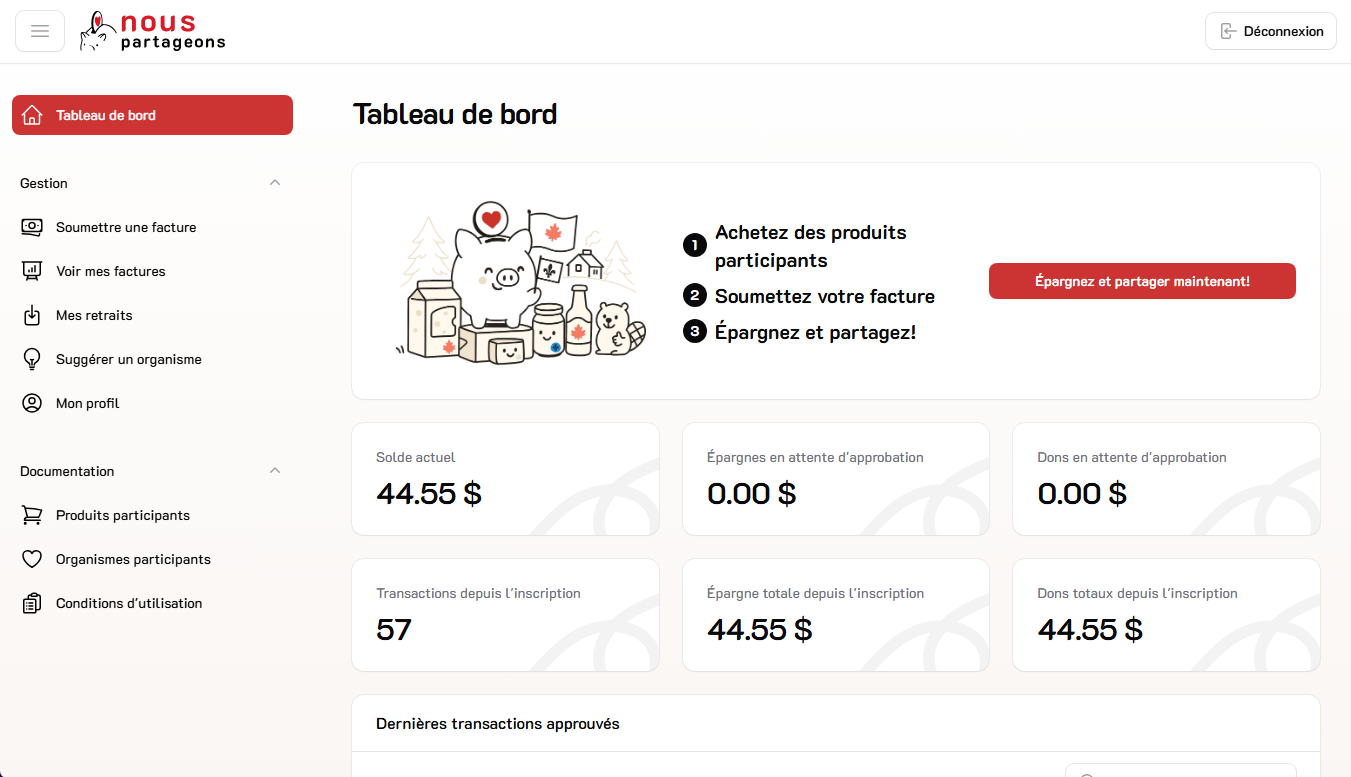
Marchand, date, taxes, total, produits et numéros extraits d’une photo ou d’un PDF.

DevActif transforme les factures, formulaires, bons de commande et autres documents en données structurées. Le système lit le contenu, applique vos règles, demande une validation lorsque nécessaire et transmet l’information au bon logiciel.
Parler de votre projet

Les formats, photos et libellés varient. Une automatisation fiable doit reconnaître ces variations sans cacher son incertitude.
Marchand, date, taxes, total, produits et numéros extraits d’une photo ou d’un PDF.
Client, lignes, quantités, prix et dates préparés pour l’ERP sans saisie complète.
Champs manuscrits ou numériques classés et associés au bon dossier.
Références, tableaux et caractéristiques retrouvés dans des formats semi-structurés.
Chaque étape est observable afin qu’une personne puisse corriger les cas ambigus et que le système apprenne des formats réels.
Téléversement mobile, courriel, dossier surveillé, numériseur ou API.
Reconnaissance du texte, des zones, des tableaux et du type de document.
Transformation des éléments utiles en champs structurés et normalisés.
Règles de cohérence, comparaison avec les données internes et degré de confiance.
File de révision simple pour les documents incomplets, illisibles ou inhabituels.
Création ou mise à jour de la transaction dans l’ERP, la comptabilité ou le portail.
Nous Partageons reçoit une photo de facture, reconnaît son contenu, identifie les produits admissibles et conserve le statut de validation.
On définit le résultat attendu, les utilisateurs, les erreurs acceptables et la façon de mesurer la valeur avant de choisir un modèle.
Un prototype vérifie la qualité des données et la précision atteignable sur des cas représentatifs, y compris les exceptions.
La fonction IA rejoint le logiciel réel avec permissions, validation humaine, journalisation et suivi de sa performance.
Reconnaissance optique, extraction structurée et gestion du degré de confiance.
Voir cette pageTransmettre ensuite les données aux logiciels qui doivent poursuivre le processus.
Voir cette pageInterroger plutôt un ensemble de documents tout en citant les sources utilisées.
Voir cette pageL’OCR transforme une image en texte. Le traitement documentaire identifie ensuite le type de document, extrait les bons champs, vérifie leur cohérence et déclenche la suite du processus. L’OCR est une étape, pas le résultat complet.
Le système attribue un degré de confiance aux champs et envoie les cas incertains dans une file de validation humaine. Il ne devrait jamais inventer silencieusement une valeur critique.
Oui. Nous commençons avec un échantillon représentatif, incluant les formats difficiles. La solution peut combiner modèles, règles et correspondances avec vos données internes afin de mieux gérer les variations.
👋 Salut, ici Marc-André !
Rendu ici, vous en savez déjà pas mal sur nous. On aimerait bien vous connaître à notre tour.
Pas de pitch, pas de pression : juste une bonne conversation sur ce que vous bâtissez, ce qui vous bloque, ce qui vous allume. Trente minutes, autour d'un café virtuel. ☕